На этой странице
Большинство технических SEO-аудитов проваливаются одинаково. В таблицу сваливают каждое предупреждение краулера и называют это стратегией. Нужен чеклист, который отделяет то, что блокирует обнаружение, от шума, — и ясное решение, что чинить в первую очередь.
Это руководство проходит по практическому чеклисту технического SEO-аудита на 2026 год: обход и robots, индексация, Core Web Vitals, структура страницы, schema, международные сигналы и что на самом деле значит «готовность к AI-поиску». Также — когда хватает бесплатного DIY-прохода и когда платный аудит стоит купить.
Что такое технический SEO-аудит (и чем он не является)
Технический SEO-аудит — это структурированная проверка того, как поисковые системы обнаруживают, рендерят и индексируют ваши URL. Он отвечает: может ли Google добраться до денежных страниц, понять их и держать в индексе без конкурирующих дублей?
Это не исследование ключевых слов, не контент-стратегия и не линкбилдинг. Всё это важно, но лежит поверх crawl и индексации. Если важные шаблоны в noindex, отдают soft 404 или спрятаны за битыми редиректами, новые посты в блоге квартал не спасут.
Главный вывод: Относитесь к аудиту как к диагностике и приоритизации. Позиции — результат правок плюс контент и ссылки, а не deliverable самого PDF.
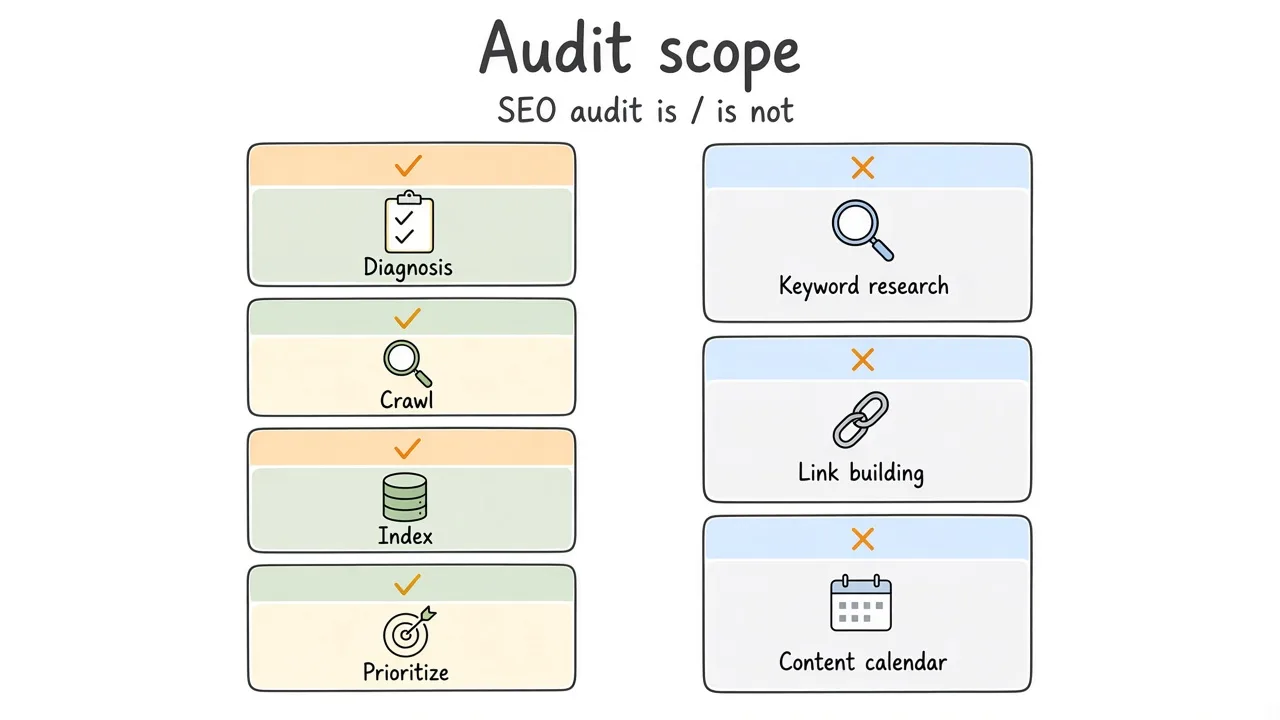
Объём аудита остаётся на crawl, индексе и приоритизации. Контент и ссылки — после того, как фундамент ясен.
Как пользоваться этим чеклистом
Работайте с одним основным доменом (и согласованными поддоменами) за раз. Когда есть доступ, опирайтесь на отчёты Google Search Console по покрытию и опыту. Добавьте crawl (Screaming Frog, Sitebulb или аналог) и точечные проверки в чистом профиле браузера.
Оценивайте каждый пункт как pass, fail или needs sampling (большие каталоги). У fail — серьёзность: блокирует денежные страницы, тратит crawl или косметика.
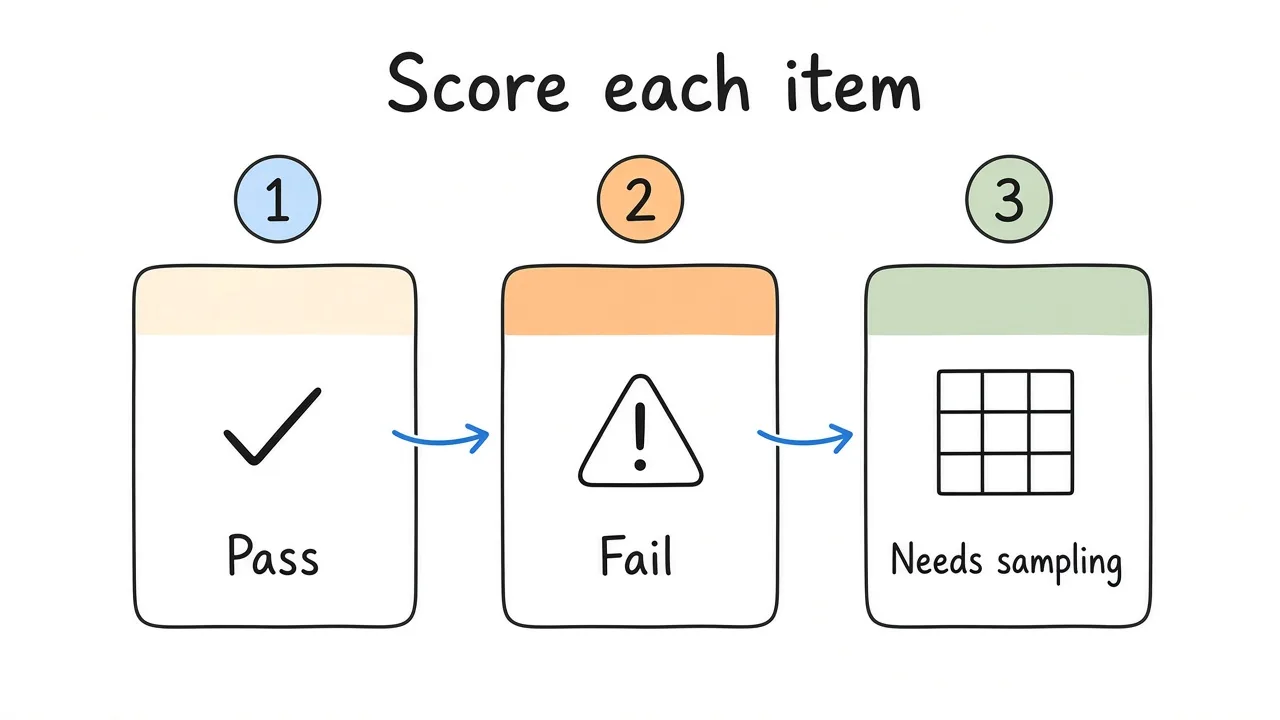
Оценивайте пункты с серьёзностью, чтобы бэклог был к отгрузке, а не свалкой каждого предупреждения краулера.
1. Доступ для crawl и robots
Начните с того, разрешено ли ботам забирать то, что важно.
- Убедитесь, что
robots.txtне блокирует CSS, JS и ключевые каталоги, которые должны индексироваться. - Проверьте случайный
Disallowна staging-путях, которые всё ещё резолвятся на проде. - Проверьте, что XML-sitemap указаны, отдают 200 и содержат только канонические, индексируемые URL.
- Сравните число URL в sitemap с числом проиндексированных в Search Console. Большие разрывы нуждаются в объяснении.
- Сэмплируйте crawl с внешнего IP. Файрволы хостинга и bot fights иногда блокируют Googlebot, выглядя нормально с вашего ноутбука.
Частая ошибка: Блокировать
/wp-admin— нормально. Блокировать/wp-jsonили целиком/cdn-cgi/без понимания, что они отдают, — так прячутся мягкие сбои.
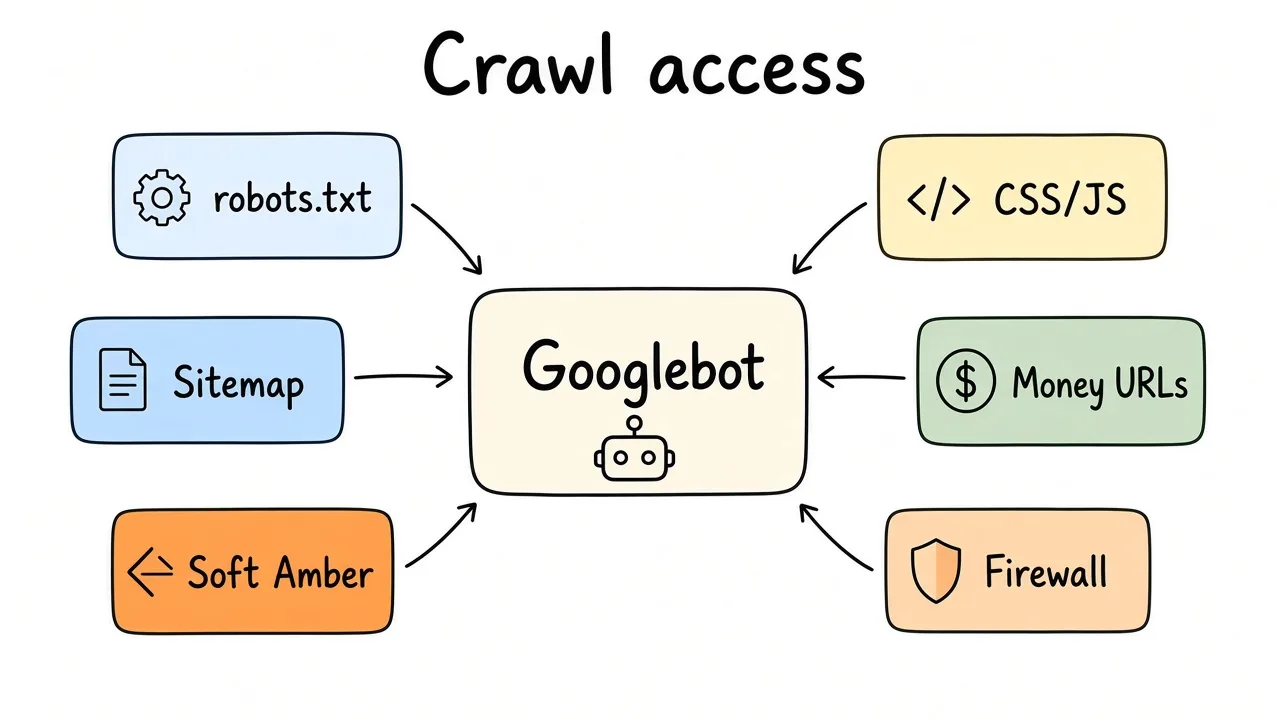
Если боты не могут забрать денежные шаблоны, остальной аудит — театр.
2. Индексация и canonical
Доступ для crawl бесполезен, если побеждают неправильные URL.
- Точечно проверьте денежные страницы через
site:и инструмент проверки URL. Подтвердите «URL есть в Google», когда так должно быть. - Проверьте noindex на шаблонах, которые должны ранжироваться (категория, товар, локация, docs).
- Сопоставьте почти-дубли: смеси HTTP/HTTPS, www и без www, варианты со слэшем в конце, копии с параметрами, print-версии.
- Подтвердите самоссылающийся или корректный
rel=canonicalна важных шаблонах. Фасетной навигации часто нужна явная стратегия, а не надежда. - Soft 404: тонкие страницы «нет результатов» с 200, пустые архивы тегов и заглушки CMS.
- Пагинация и бесконечный скролл: убедитесь, что путь для crawl к глубоким позициям всё ещё есть.
| Сигнал | Здоровый паттерн | Красный флаг |
|---|---|---|
| Canonical | Указывает на предпочтительный денежный URL | Указывает на параметр или устаревший путь |
| Status | 200 для индексируемых | Soft 404-контент на 200 |
| Sitemap | Совпадает с предпочтительными URL | Включает редиректы и URL с noindex |
| Hreflang | Взаимный, где используется | Односторонний или неверные коды языка |
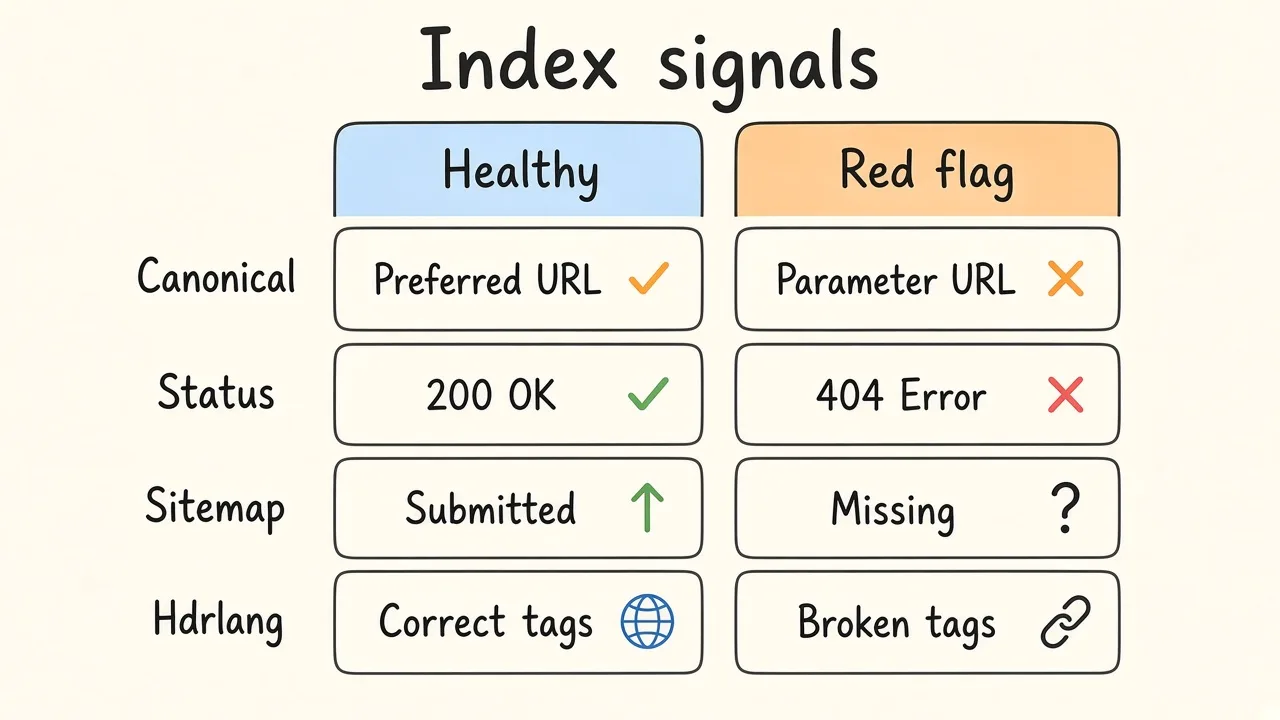
Canonical, status, sitemap и hreflang должны указывать на предпочтительные денежные URL, а не на копии с параметрами.
3. Рендеринг и Core Web Vitals
Системы Google используют сигналы опыта страницы. Полевые данные реальных пользователей сильнее одного скриншота Lighthouse.
- Возьмите Core Web Vitals из Search Console и CrUX, где доступно.
- Лабораторно протестируйте ключевые шаблоны (главная, листинг, статья, товар, checkout если публичный).
- Отметьте элемент LCP: hero-изображение, блокировка веб-шрифтом или поздний клиентский рендер.
- Отметьте источники CLS: внедрённые баннеры, поздняя реклама, медиа без размеров.
- Отметьте проблемы INP на интерактивных шаблонах (фильтры, меню, корзины).
- Тяжёлые сторонние скрипты: tag managers, чат-виджеты, A/B-инструменты. Измеряйте стоимость, не гадайте.
Лучшая практика: Чините класс шаблона, а не один вирусный URL. Один шаблон товара может убить CWV для тысяч страниц.
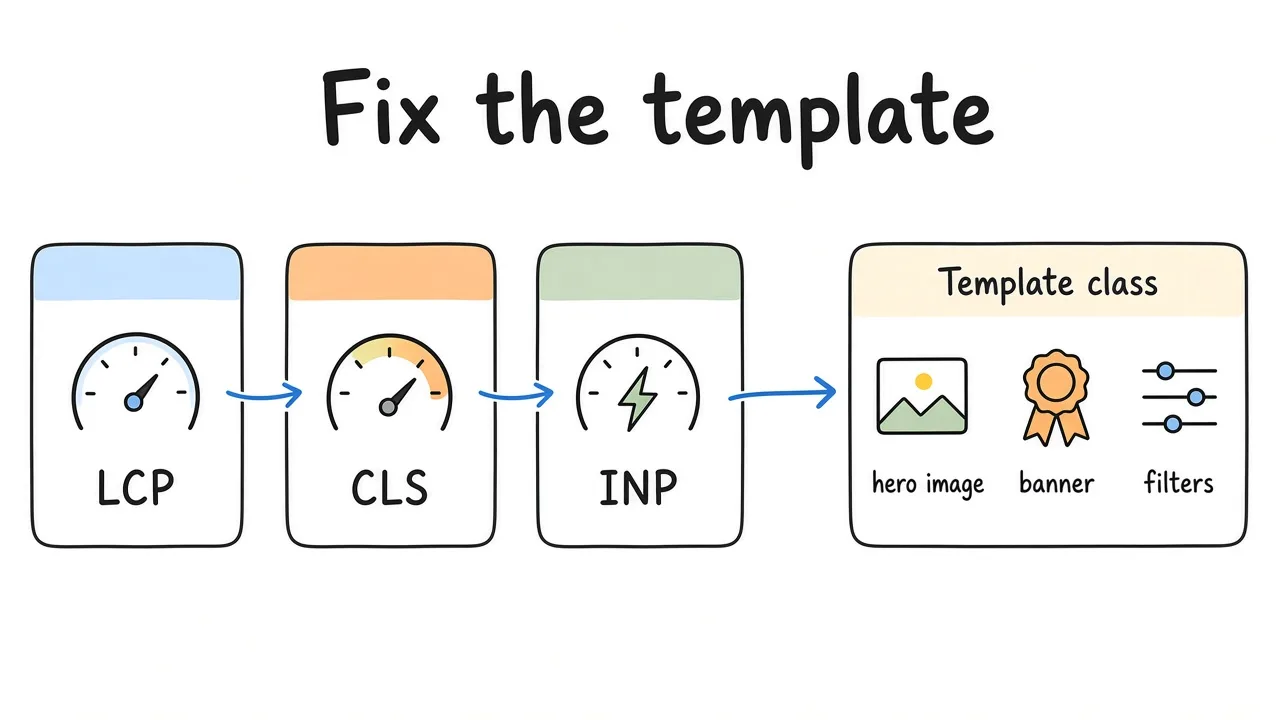
Core Web Vitals принадлежат шаблону. Полевые данные сильнее одного удачного скриншота Lighthouse.
4. Структура страницы и внутренние ссылки
В технический SEO входит и то, понятен ли HTML.
- Уникальные, точные title на денежных шаблонах. Без переспама ключами.
- Один ясный H1, соответствующий задаче страницы.
- Иерархия заголовков, отражающая контент, а не случайность дизайна.
- Внутренние ссылки с хабов на денежные страницы. Orphan-URL, найденные только в sitemap, — запах.
- Тонкие или почти пустые шаблоны, конкурирующие с более богатыми соседями.
- Битые ссылки и цепочки редиректов в основной навигации и футере.
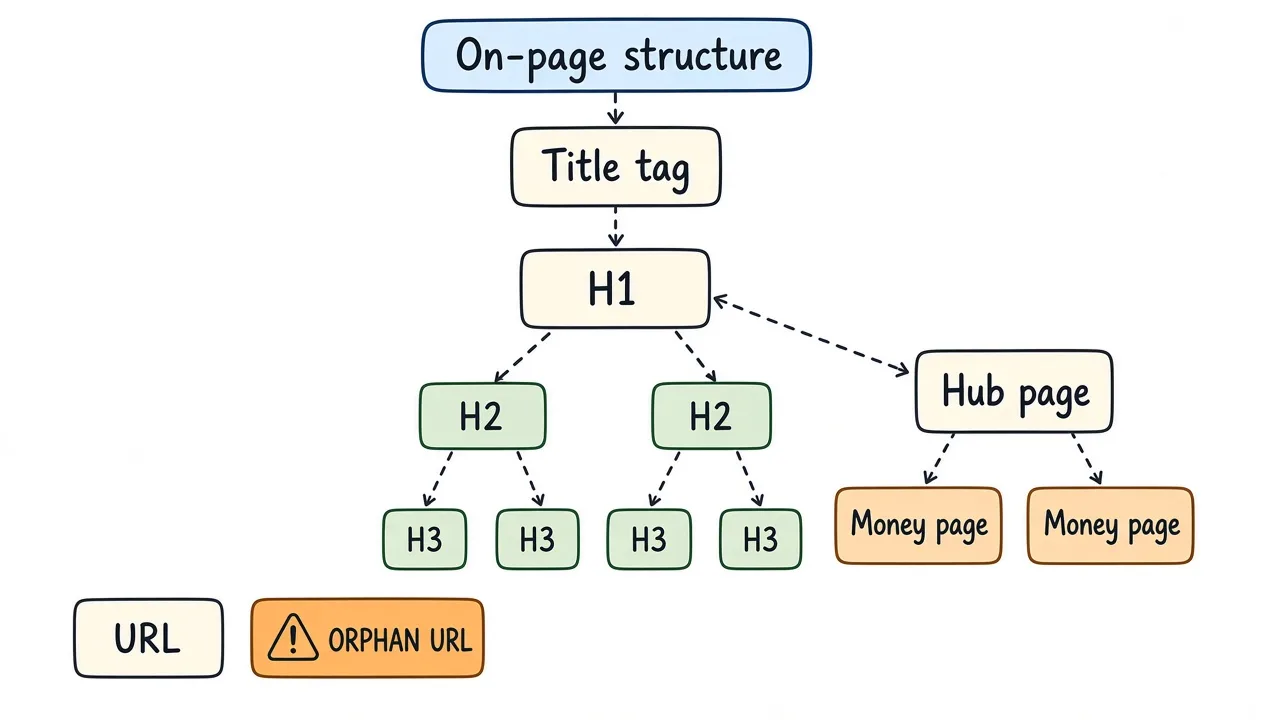
Иерархия заголовков и ссылки хаб→деньги важны не меньше самого crawl.
5. Структурированные данные и расширенные результаты
Schema не поднимает вас в выдаче по волшебству. Она может прояснить сущности и открыть rich results, когда совпадает с видимым контентом.
- Валидируйте инструментами Google для rich results и отчётами об улучшениях в Search Console.
- Предпочитайте типы, которые можете честно поддержать: Article, Product, FAQ, Organization, BreadcrumbList.
- Уберите конфликтующий или устаревший JSON-LD от старых тем и плагинов.
- Держите разметку в согласии с тем, что видит пользователь. Фейковая FAQ schema — проблема доверия.
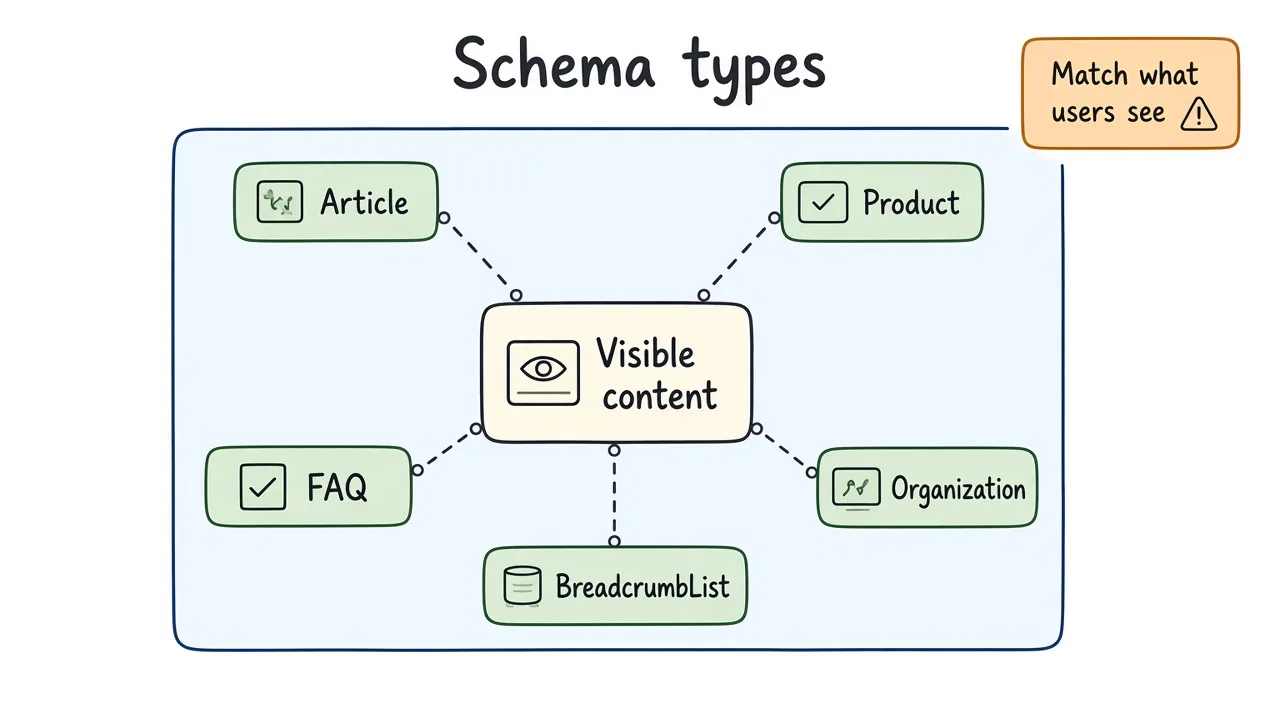
Schema помогает только когда совпадает с тем, что пользователь видит на странице.
6. Международное SEO и hreflang (когда актуально)
Если у вас больше одной локали, международное SEO — часть технического аудита.
- Паттерн URL локалей согласован (папка, поддомен или ccTLD) и задокументирован.
- Аннотации
hreflangвзаимны и используют валидные коды языка или региона. - x-default указывает куда-то намеренно.
- Переключатели языка не создают crawl-ловушки и дублирующие наборы параметров.
Если язык один — пропустите этот раздел. Не изобретайте hreflang ради эстетики.
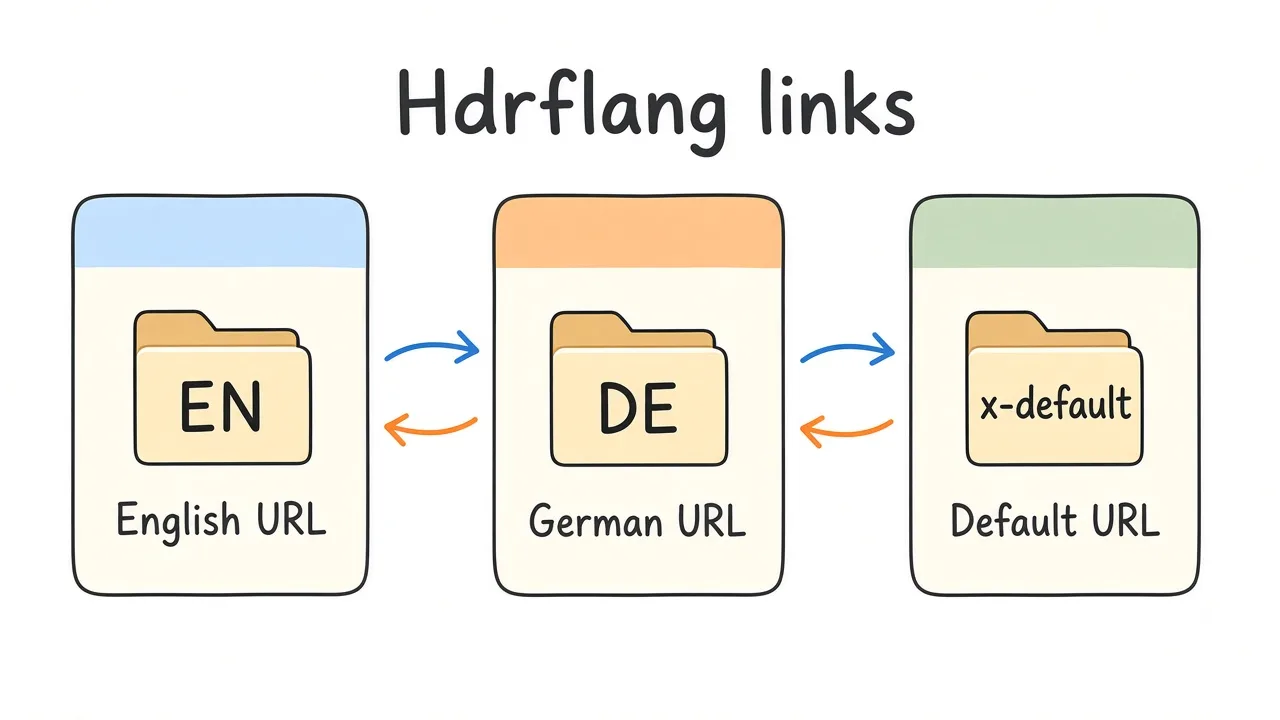
Hreflang должен быть взаимным. Односторонние аннотации — частый режим отказа.
7. Готовность к AI-поиску без театра
Маркетинг «AI SEO» часто означает автоматизированный спам. В техническом аудите готовность к AI-поиску скучнее и полезнее:
- Ясный, обходимый HTML для основного контента (не запертый за несущественным клиентским рендером).
- Стабильные канонические URL, чтобы цитаты и сниппеты указывали на правильную страницу.
- Точные titles, заголовки и schema, совпадающие со страницей.
- Сигналы свежести и авторства, где они честны (существующие страницы авторов, даты, обновляемые при изменении контента).
- Без cloaking, doorway-ферм и AI-сгенерированных doorway-страниц.
Нельзя «оптимизировать под рейтинги ChatGPT» плагином. Можно сделать страницы удобными для загрузки, цитирования и атрибуции.
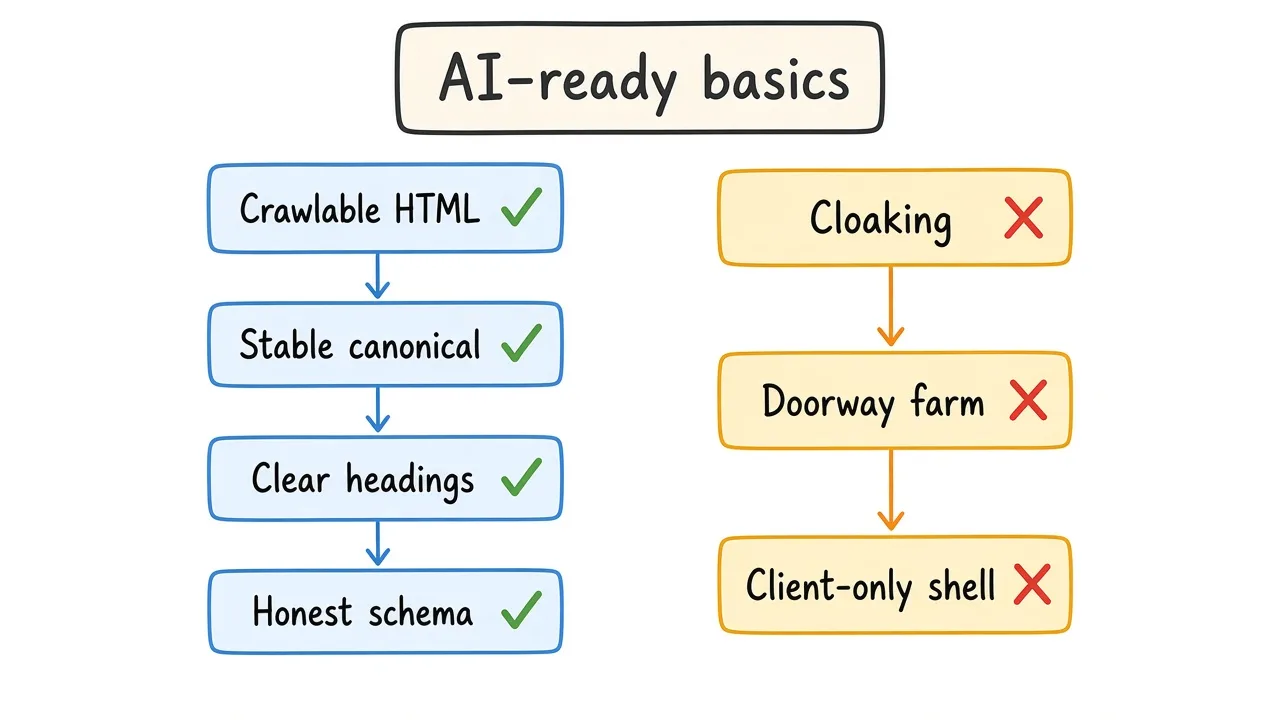
Готовность к AI-поиску — это обходимые, ясные, атрибутируемые страницы, а не плагин, обещающий цитаты.
Порядок приоритетов, когда всё горит
- Вернуть заблокированные или деиндексированные денежные страницы.
- Исправить битые canonical и soft 404-шаблоны.
- Схлопнуть цепочки редиректов после миграций.
- Стабилизировать Core Web Vitals на шаблонах с высоким трафиком.
- Почистить внутреннюю перелинковку и столкновения тонких шаблонов.
- Schema и международная полировка.
Всё, что затрагивает только редко посещаемый архив, может подождать.
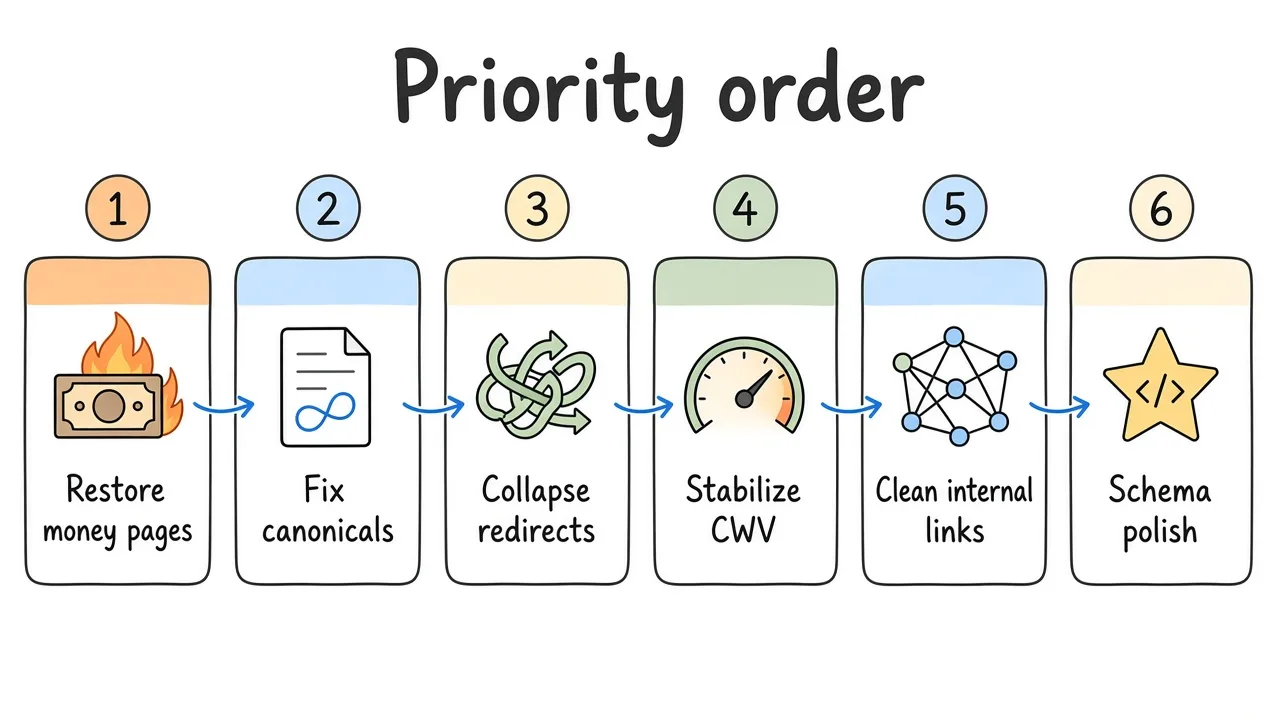
Отгружайте блокеры, которые восстанавливают обнаружение денежных страниц, прежде чем полировать schema.
DIY-аудит против платного аудита
Делайте сами, когда:
- Есть доступ к Search Console и небольшой сайт (десятки — низкие сотни индексируемых URL).
- Режим отказа очевиден (миграция, случайный noindex, блок в robots).
- Разработчик может отгрузить правки без длинной очереди.
Покупайте платный аудит, когда:
- Трафик упал после редизайна или смены CMS, и никто не согласен почему.
- Сложность каталога или мультиязычности требует сэмплирования.
- Нужен приоритизированный бэклог с владельцами (dev, контент, хостинг) до ретейнера.
- Предыдущие агентства оставили конфликтующие плагины, sitemap и остатки «AI SEO».
Предупреждение: Аудит сам по себе не создаёт позиции. Если страница продукта слабая или market fit неверный, техническая работа только расчищает взлётную полосу.
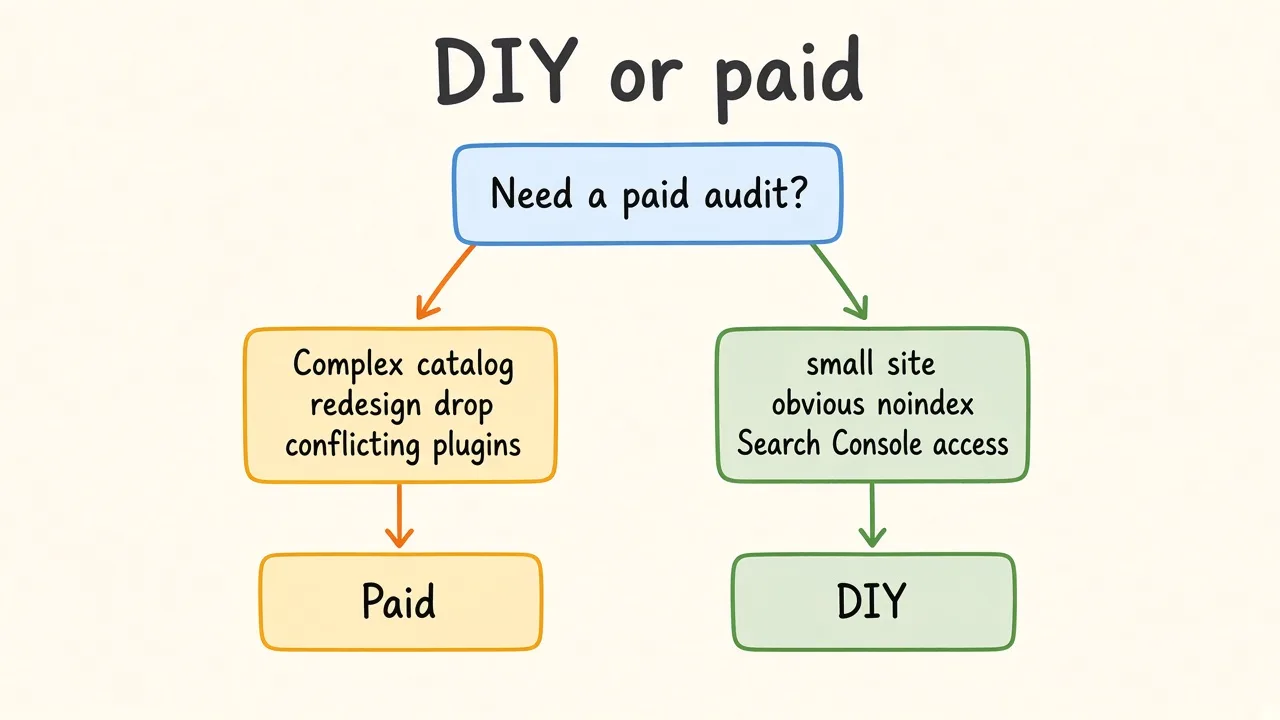
DIY работает при малых очевидных сбоях. Покупайте помощь, когда сложность или падение после редизайна требуют приоритизированного бэклога.
Если нужен практический проход с ранжированным списком правок вместо 80-страничной свалки, смотрите страницу услуги технический SEO-аудит.
Разбор сценария: падение после редизайна
B2B-сайт переезжает с WordPress на JavaScript-фреймворк. Органические сессии падают на 40% за шесть недель.
Находки чеклиста:
- Важные маршруты docs отдают клиентские оболочки с тонким первым HTML.
- Старые URL
/blog/*отдают 404 без карты редиректов. - Sitemap всё ещё перечисляет legacy-пути.
- Canonical на новых листингах указывают на главную.
Первый спринт: карта редиректов для legacy URL, правка canonical, отправка обновлённого sitemap, улучшение server-rendered HTML для шаблонов docs. Контент и ссылки — после того, как это сядет.
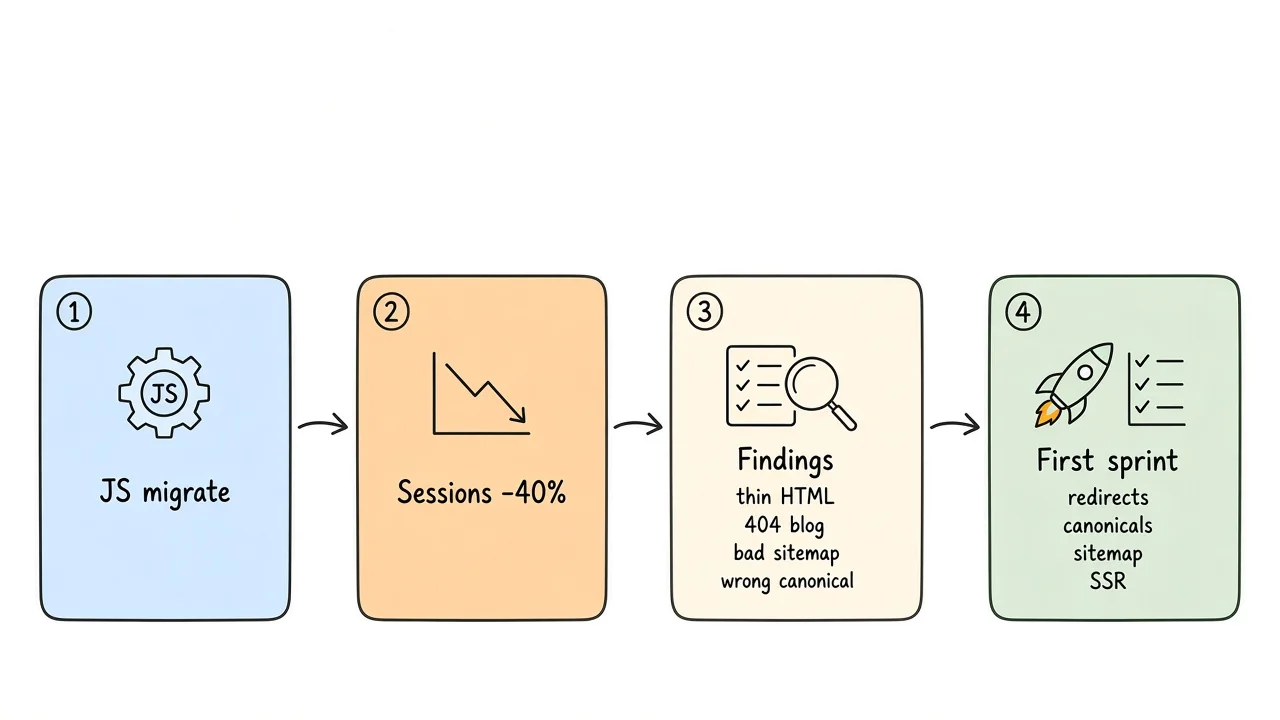
Редиректы, canonical, sitemap и server-rendered HTML садятся раньше контента и ссылок.
Часто задаваемые вопросы
Сколько длится технический SEO-аудит?
Большинство аудитов одного домена занимают около одной–двух недель после готовности доступов. Очень большие каталоги получают scoped-сэмпл шаблонов плюс план на остальное.
Нужен ли Search Console для полезного аудита?
Сильно помогает. Без него crawl плюс публичные проверки URL всё равно находят много проблем, но покрытие и полевые данные CWV будут тоньше.
Это то же самое, что полный SEO-пакет?
Нет. Этот чеклист — техническая диагностика и приоритизация. Контент-стратегия, digital PR и ongoing-оптимизация — отдельно, когда фундамент ясен.
Гарантируют ли эти правки позиции?
Ни один честный оператор не должен это обещать. Технические правки снимают блокеры, чтобы контент и ссылки могли работать. Google по-прежнему ранжирует относительно конкурентов и релевантности.
А что насчёт AI Overviews и «GEO»?
Держите страницы обходимыми, ясными и атрибутируемыми. Пропускайте схемы с обещанием гарантированных AI-цитат. Экспериментальные фичи — вторичны относительно солидной индексации и полезных страниц.
Что делать дальше
Прогоните crawl и проверки Search Console по порядку, напишите короткий бэклог с серьёзностью и отгрузите верхние блокеры, прежде чем наращивать производство контента. Если нужен второй взгляд на бэклог или внедрение, напишите через контактную форму — скоупируем сфокусированный технический SEO-аудит.