このページの内容
多くのテクニカルSEO監査は同じ失敗をします。クローラーの警告をすべてスプレッドシートに吐き出して、それを戦略と呼ぶのです。必要なのは、発見を妨げるものとノイズを分け、何を先に直すかをはっきり示すチェックリストです。
このガイドでは、2026年向けの実践的なテクニカルSEO監査チェックリストを歩きます。クロールとrobots、インデックス、Core Web Vitals、オンページ構造、スキーマ、国際シグナル、そして「AI検索への備え」が実際に何を意味するかまで。無料の自前パスで足りる場合と、有料監査を買う価値がある場合も扱います。
テクニカルSEO監査とは何か(そして何ではないか)
テクニカルSEO監査は、検索エンジンがURLを発見・レンダリング・インデックスする方法の構造的レビューです。答えは次の問いです。Googleは収益ページに到達し、理解し、競合する重複なしにインデックスに保てるか?
キーワード調査、コンテンツ戦略、リンク構築ではありません。それらは重要ですが、クロールとインデックスの上にあります。重要なテンプレートがnoindex、ソフト404、壊れたリダイレクトの裏に埋まっているなら、ブログ記事を増やしても四半期は救えません。
要点: 監査を診断と優先順位づけとして扱うこと。ランキングはPDFそのものの成果物ではなく、修正+コンテンツ+リンクの結果です。
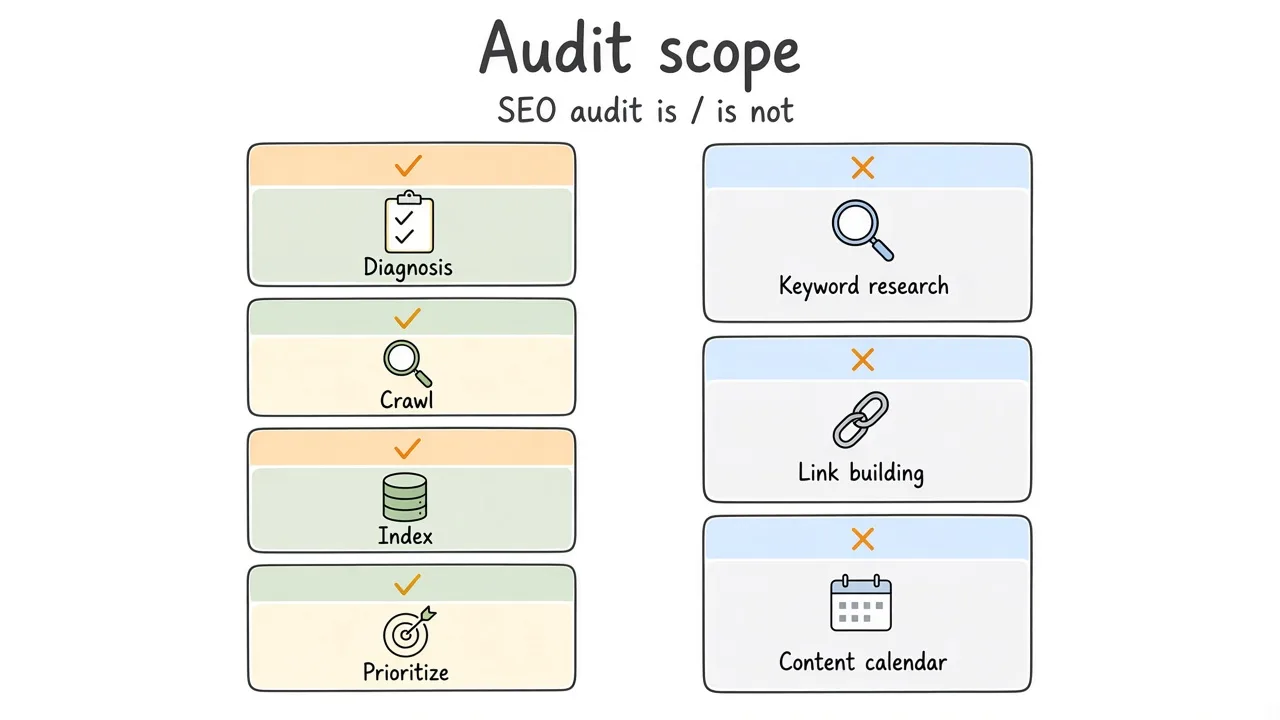
監査の範囲はクロール、インデックス、優先順位づけにとどめます。コンテンツとリンクは土台が明確になってから。
このチェックリストの使い方
一次ドメイン(合意したサブドメイン)を一度にひとつ扱います。アクセスがある場合はGoogle Search Consoleのカバレッジと体験レポートを優先します。クロール(Screaming Frog、Sitebulbなど)と、クリーンなブラウザプロファイルでのスポットチェックを組み合わせます。
各項目を合格、不合格、またはサンプリングが必要(大規模カタログ)で採点します。不合格には深刻度を付けます。収益ページを阻害、クロールを浪費、または見た目だけ、のいずれかです。
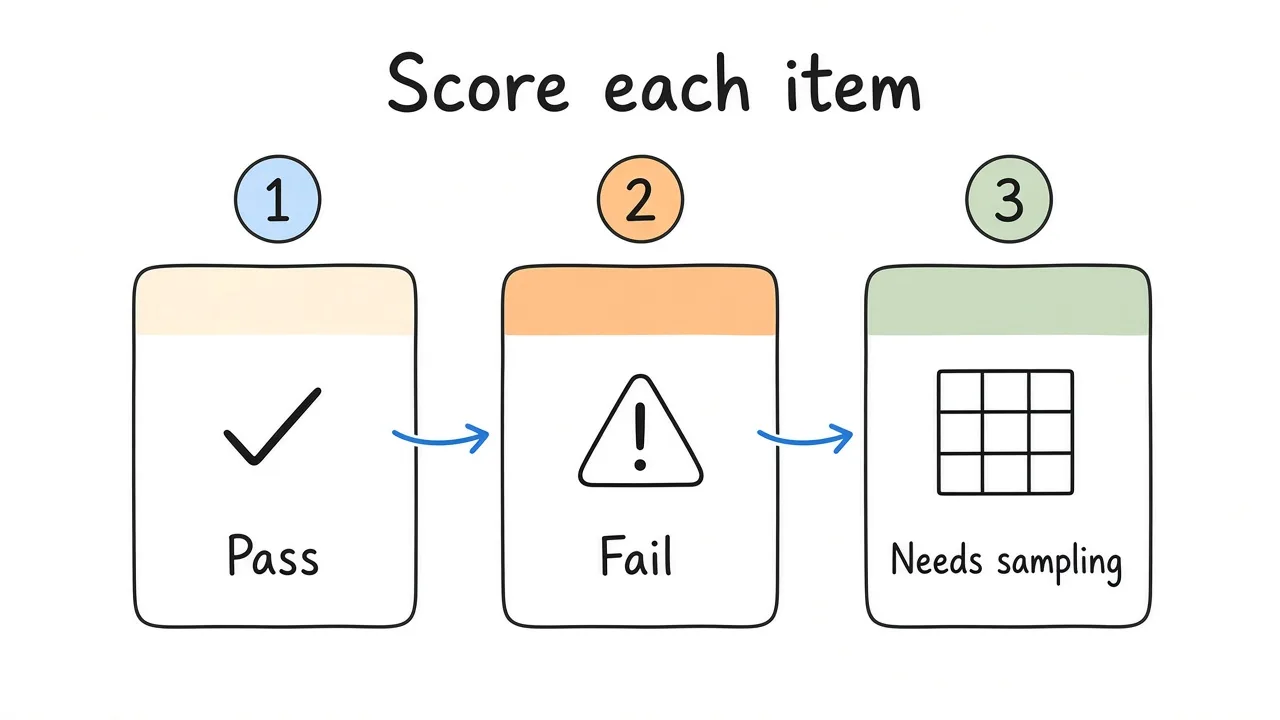
深刻度付きで採点すれば、バックログは出荷可能になり、クローラー警告の単なるダンプにはなりません。
1. クロールアクセスとrobots
ボットが重要なものを取得できるかどうかから始めます。
robots.txtが、インデックスすべきCSS、JS、主要ディレクトリをブロックしていないか確認する。- 本番でまだ解決してしまうステージングパスへの誤った
Disallowがないか確認する。 - XMLサイトマップが掲載され、200を返し、正規でインデックス可能なURLだけを含むことを検証する。
- サイトマップのURL数とSearch Consoleのインデックス済みURL数を比較する。大きな差には理由が必要。
- 外部IPからサンプルクロールする。ホスティングのファイアウォールやボット対策が、手元では問題なくてもGooglebotをブロックすることがある。
よくある失敗:
/wp-adminのブロックは問題ありません。/wp-jsonや/cdn-cgi/全体を、何を提供しているか理解せずにブロックすると、ソフトな失敗が隠れます。
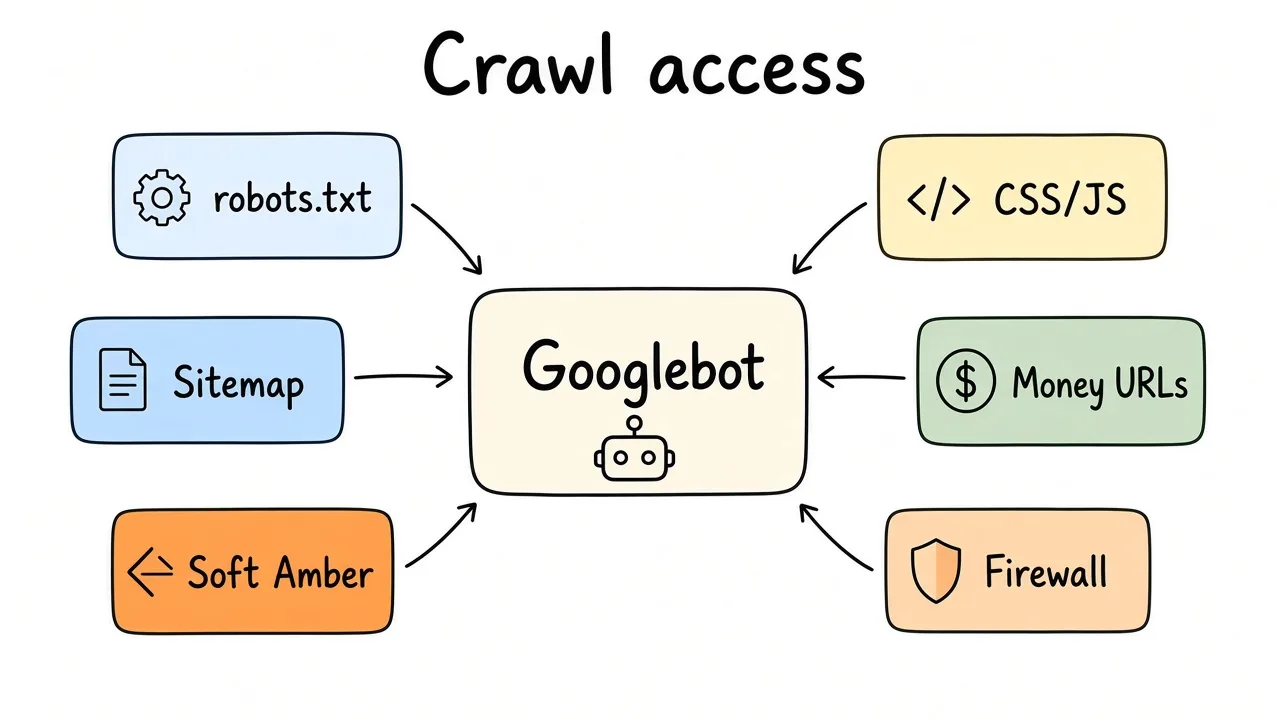
ボットが収益テンプレートを取得できなければ、監査の残りは芝居です。
2. インデックスとカノニカル
クロールアクセスがあっても、誤ったURLが勝っては意味がありません。
- 収益ページを
site:とURL検査ツールでスポットチェックする。あるべきときに「URLはGoogleに登録されています」であることを確認する。 - ランクすべきテンプレート(カテゴリ、商品、ロケーション、ドキュメント)のnoindexを確認する。
- ほぼ重複をマッピングする。HTTP対HTTPS、www対非www、末尾スラッシュの揺れ、パラメータコピー、印刷ビュー。
- 重要なテンプレートで自己参照または正しい
rel=canonicalを確認する。ファセットナビには希望ではなく明示的な戦略が必要なことが多い。 - ソフト404:200を返す薄い「結果なし」ページ、空のタグアーカイブ、プレースホルダーCMSシェル。
- ページネーションと無限スクロール:深いアイテムへのクロール可能な経路がまだあることを確認する。
| シグナル | 健全なパターン | 赤旗 |
|---|---|---|
| カノニカル | 優先する収益URLを指す | パラメータや古いパスを指す |
| ステータス | インデックス対象は200 | 200上のソフト404コンテンツ |
| サイトマップ | 優先URLと一致 | リダイレクトやnoindex URLを含む |
| Hreflang | 使用時は相互確認 | 片方向または誤った言語コード |
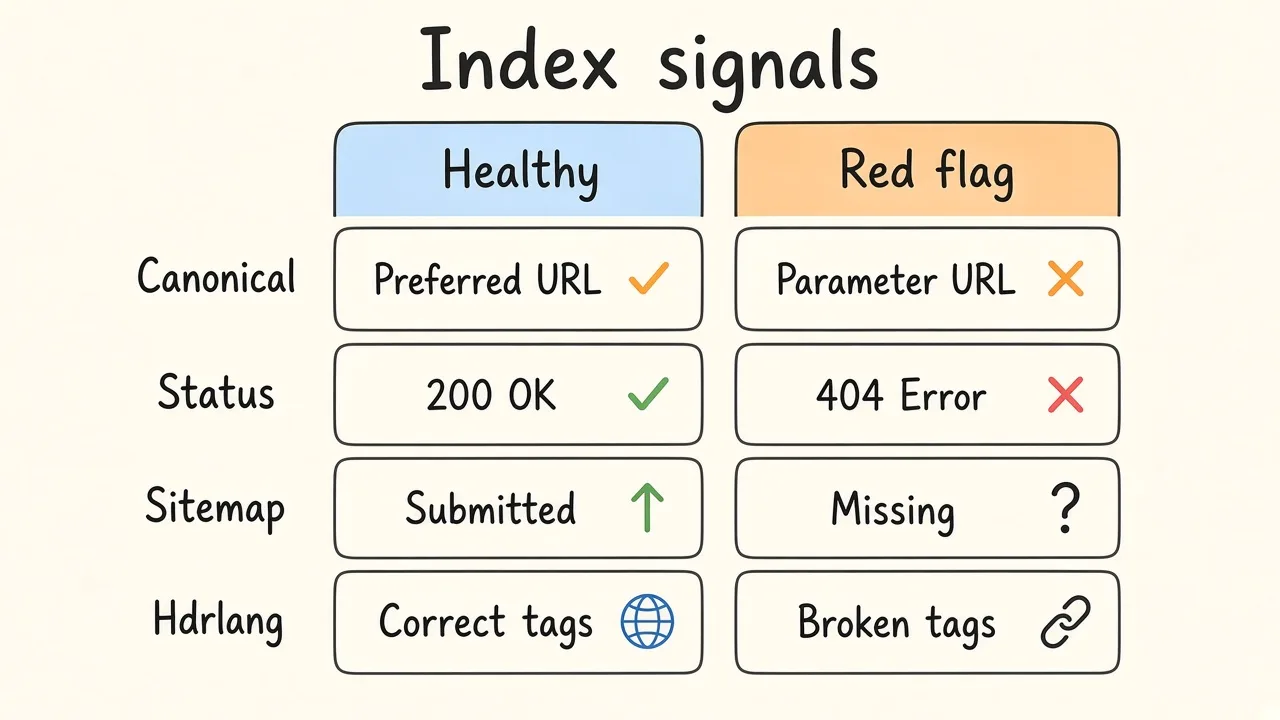
カノニカル、ステータス、サイトマップ、hreflangは、パラメータコピーではなく優先する収益URLを指すべきです。
3. レンダリングとCore Web Vitals
Googleのシステムはページ体験シグナルを使います。実ユーザーのフィールドデータは、1枚のLighthouseスクリーンショットより優先です。
- Search Consoleと、可能な場合はCrUXからCore Web Vitalsを取得する。
- 主要テンプレート(ホーム、一覧、記事、商品、公開ならチェックアウト)をラボテストする。
- LCP要素を記録する。ヒーロー画像、Webフォントのブロック、または遅いクライアントレンダー。
- CLSの原因を記録する。注入バナー、遅い広告、サイズ未指定のメディア。
- インタラクティブなテンプレート(フィルター、メニュー、カート)のINP問題を記録する。
- 重いサードパーティスクリプト:タグマネージャー、チャットウィジェット、A/Bツール。コストを測り、推測しない。
ベストプラクティス: バイラルな1URLではなく、テンプレートクラスを直すこと。1つの商品テンプレートが何千ページのCWVを壊し得ます。
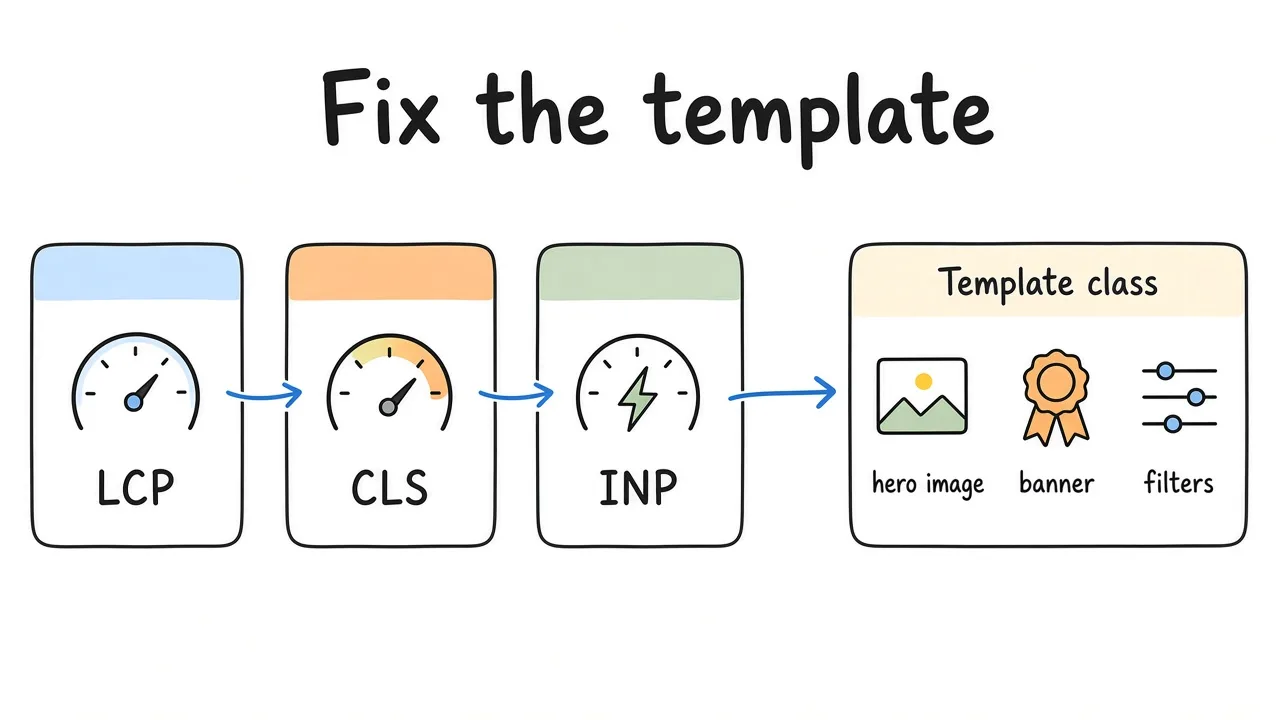
Core Web Vitalsはテンプレートのものです。フィールドデータは幸運なLighthouseの1枚より優先です。
4. オンページ構造と内部リンク
テクニカルSEOには、HTMLが理解可能かどうかも含まれます。
- 収益テンプレートで一意で正確なタイトルタグ。キーワードの詰め込みなし。
- ページの役割に合う明確なH1を1つ。
- コンテンツを映す見出し階層。デザインの事故ではないもの。
- ハブから収益ページへの内部リンク。サイトマップにしかない孤立URLは臭い。
- より豊かな兄弟と競合する薄い/ほぼ空のテンプレート。
- 主要ナビとフッターの壊れたリンクとリダイレクトチェーン。
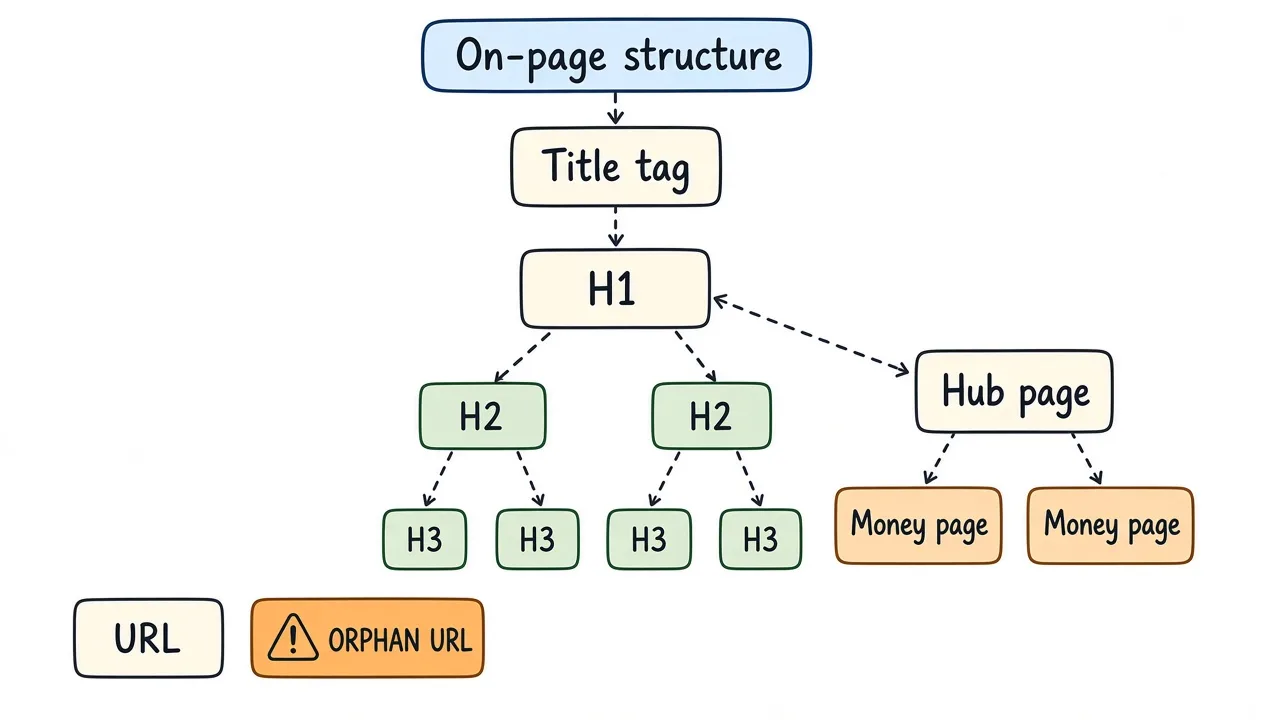
見出し階層とハブから収益へのリンクは、クロールそのものと同じくらい重要です。
5. 構造化データとリッチリザルト
スキーマは魔法でランクさせません。エンティティを明確にし、表示コンテンツと一致するときにリッチリザルトを開けることがあります。
- GoogleのリッチリザルトツールとSearch Consoleの拡張レポートで検証する。
- 正直に支えられる型を優先する。Article、Product、FAQ、Organization、BreadcrumbList。
- 古いテーマやプラグインが残した矛盾・古いJSON-LDを削除する。
- マークアップをユーザーが見るものと揃える。偽のFAQスキーマは信頼の問題です。
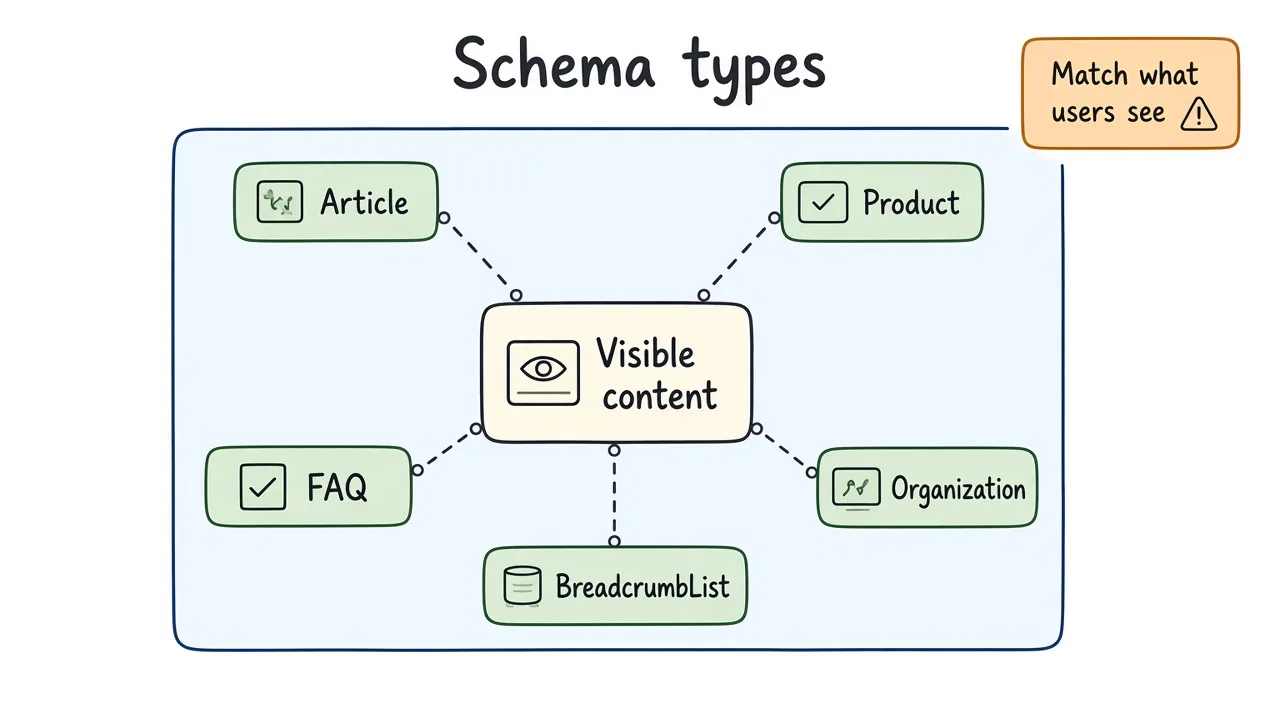
スキーマは、ユーザーがページ上で見られるものと一致するときだけ役立ちます。
6. 国際とhreflang(該当する場合)
複数ロケールを運用するなら、国際SEOはテクニカル監査の一部です。
- ロケールURLパターンが一貫している(フォルダ、サブドメイン、またはccTLD)し、文書化されている。
hreflang注釈が相互確認され、有効な言語/地域コードを使う。- x-defaultが意図した場所を指す。
- 言語スイッチャーがクロールトラップや重複パラメータセットを作らない。
言語が1つだけなら、この節はスキップします。見た目のためにhreflangを発明しないでください。
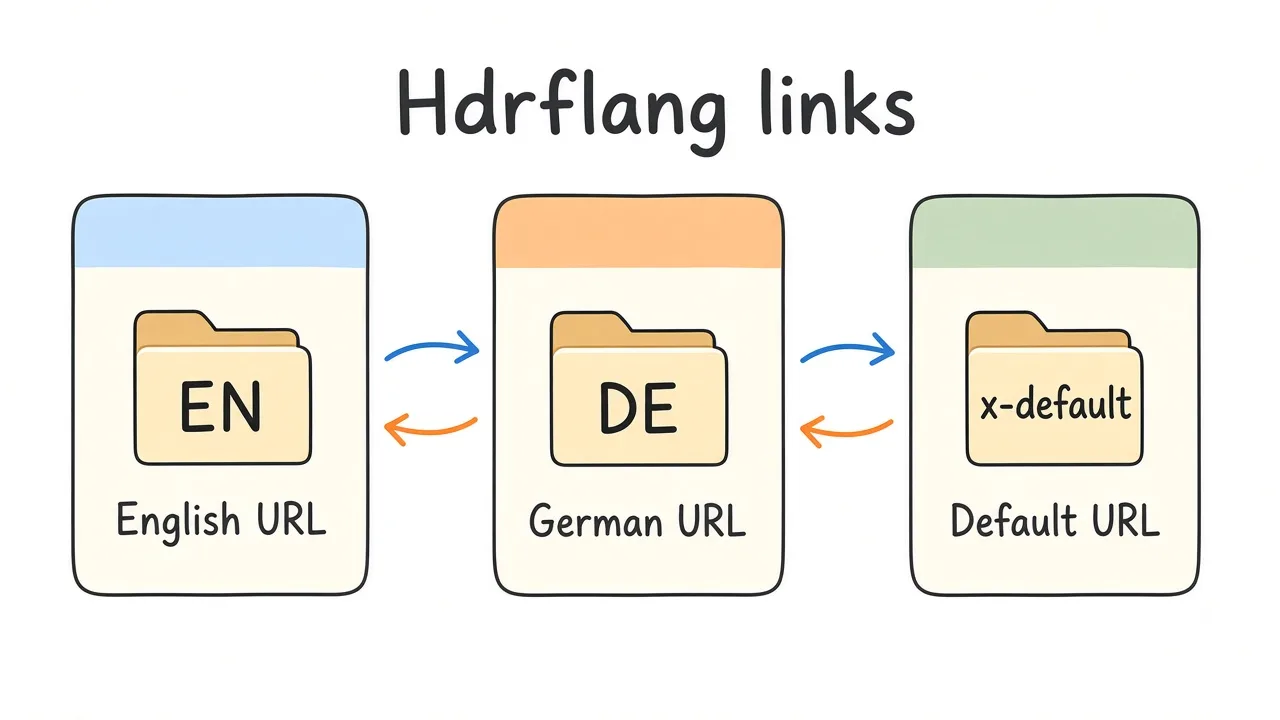
Hreflangは相互確認が必要です。片方向の注釈はよくある失敗モードです。
7. 芝居なしのAI検索への備え
「AI SEO」マーケティングはしばしば自動スパムを意味します。テクニカル監査では、AI検索への備えはより地味で、より有用です。
- 主要コンテンツ向けの明確でクロール可能なHTML(必須でないクライアントレンダリングの裏にロックされていない)。
- 引用やスニペットが正しいページを指すための安定したカノニカルURL。
- ページと一致する正確なタイトル、見出し、スキーマ。
- 正直な鮮度と著者シグナル(実際に存在する著者ページ、コンテンツ変更時に更新される日付)。
- クローキング、ドアウェイファーム、AI生成ドアウェイページなし。
「ChatGPTランキング向けに最適化」するプラグインはありません。ページを取得しやすく、引用しやすく、帰属しやすくすることはできます。
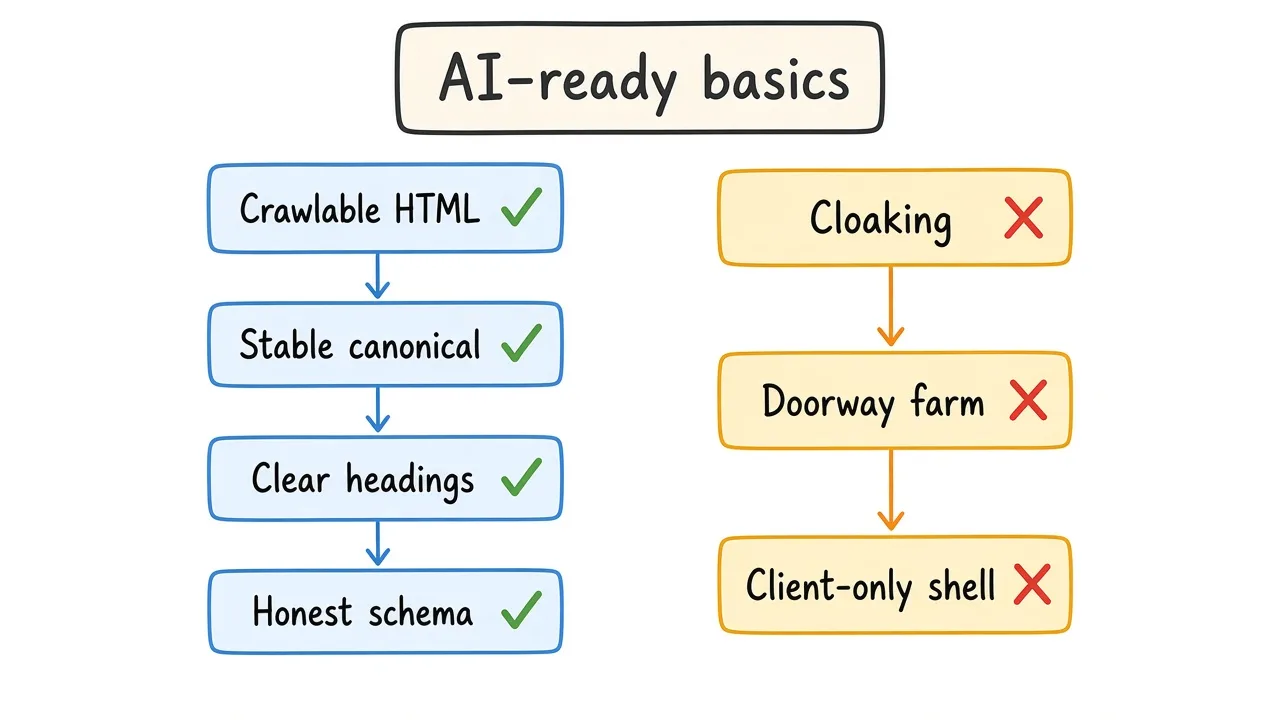
AI検索への備えは、引用を約束するプラグインではなく、クロール可能で明確で帰属可能なページです。
すべてが炎上しているときの優先順位
- ブロックまたはインデックス解除された収益ページを復元する。
- 壊れたカノニカルとソフト404テンプレートを直す。
- 移行からのリダイレクトチェーンを潰す。
- 高トラフィックテンプレートのCore Web Vitalsを安定させる。
- 内部リンクと薄いテンプレートの衝突を整理する。
- スキーマと国際の仕上げ。
めったに訪問されないアーカイブだけに影響するものは後回しで構いません。
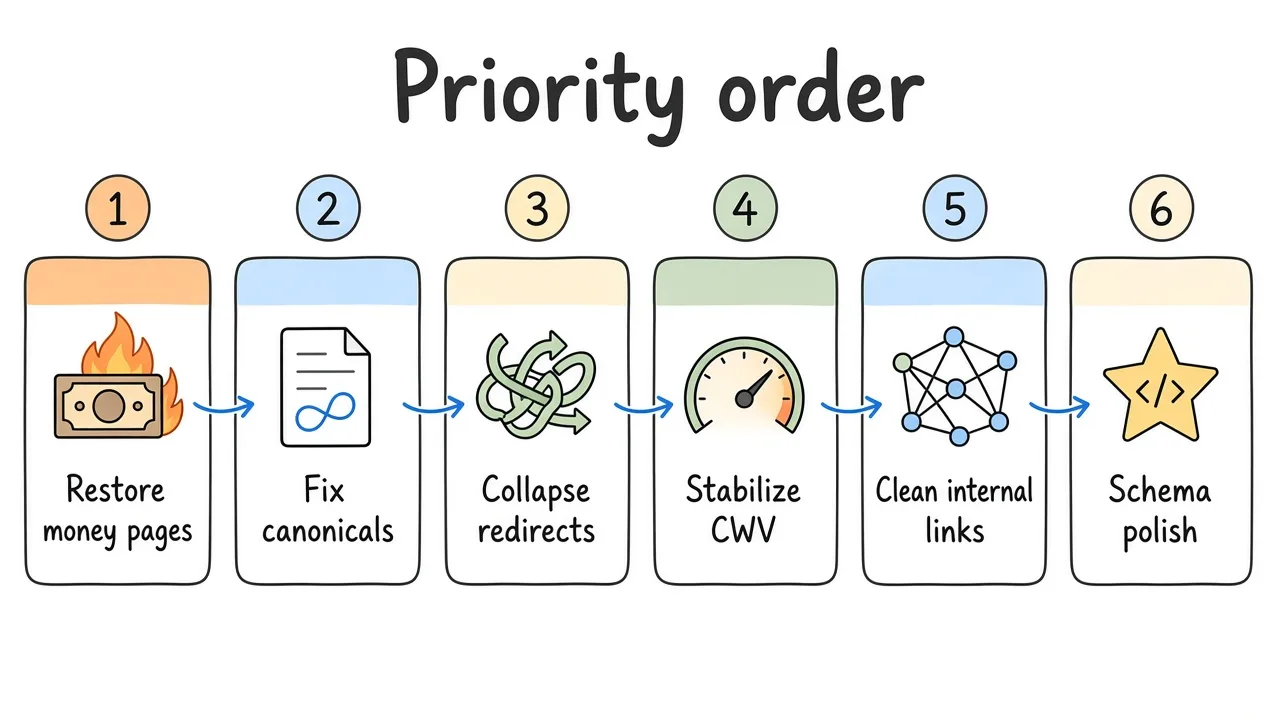
スキーマを磨く前に、収益ページの発見を復元するブロッカーを出荷します。
DIY監査対有料監査
自前でやる場合:
- Search Consoleアクセスがあり、サイトが小さい(インデックス可能なURLが数十〜数百)。
- 失敗モードが明白(移行、誤ったnoindex、robotsブロック)。
- 開発者が長い待ち行列なしに修正を出荷できる。
有料監査を買う場合:
- リデザインやCMS移行後にトラフィックが落ち、誰も理由に合意できない。
- カタログやマルチロケールの複雑さでサンプリングが必要。
- リテイナー前に、担当者付き(開発、コンテンツ、ホスティング)の優先バックログが必要。
- 以前の代理店が矛盾するプラグイン、サイトマップ、「AI SEO」の残骸を残した。
警告: 監査だけではランキングは生まれません。商品ページが弱いか、市場適合が誤っていれば、テクニカル作業は滑走路を整えるだけです。
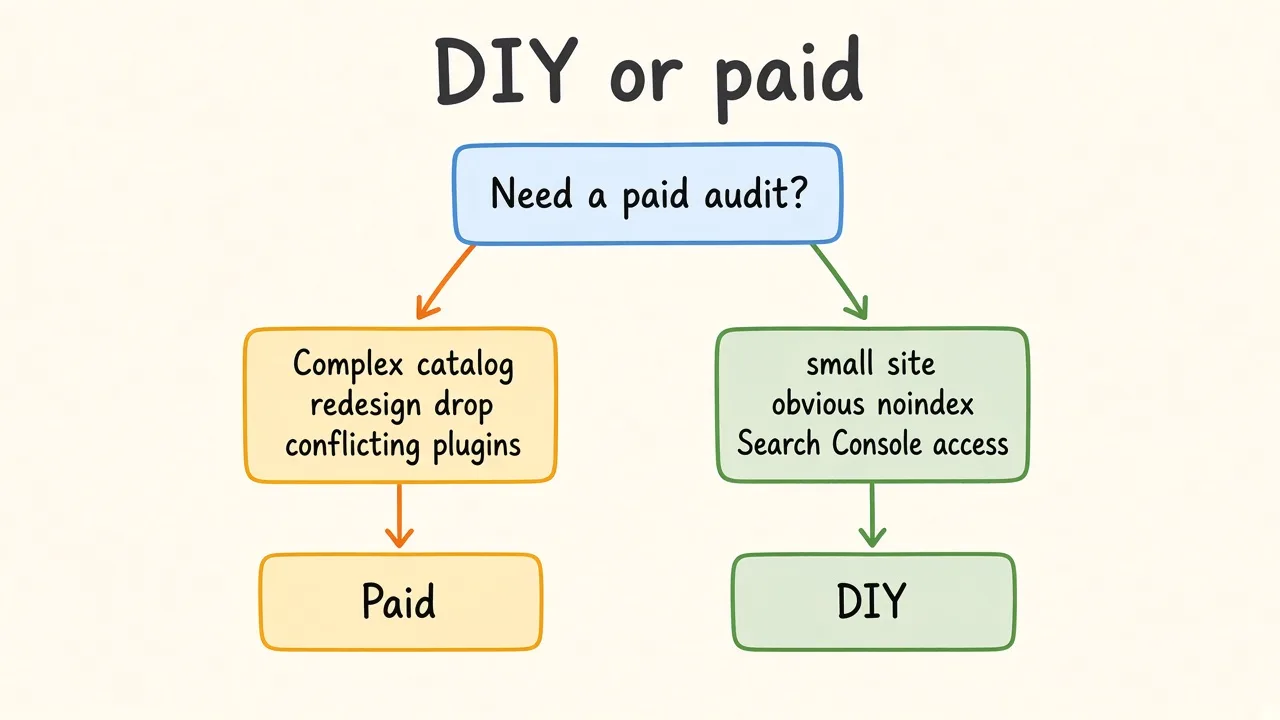
DIYは小さく明白な失敗に効きます。複雑さやリデザイン後の下落で優先バックログが必要なときは助けを買う。
80ページのダンプではなく、順位付き修正リスト付きの実務パスが欲しければ、テクニカルSEO監査のサービスページを参照してください。
実践シナリオ:リデザイン後の下落
B2BサイトがWordPressからJavaScriptフレームワークへ移行。オーガニックセッションが6週間で40%下落。
チェックリストの所見:
- 重要なドキュメントルートが、薄い初回HTMLのクライアントレンダードシェルを返す。
- 古い
/blog/*URLがリダイレクトマップなしで404。 - サイトマップがまだレガシーパスを列挙。
- 新しい一覧ページのカノニカルがホームページを指す。
最初のスプリント:レガシーURLのリダイレクトマップ、カノニカル修正、更新サイトマップ提出、ドキュメントテンプレートのサーバーレンダードHTML改善。コンテンツとリンクはそれらが着地してから。
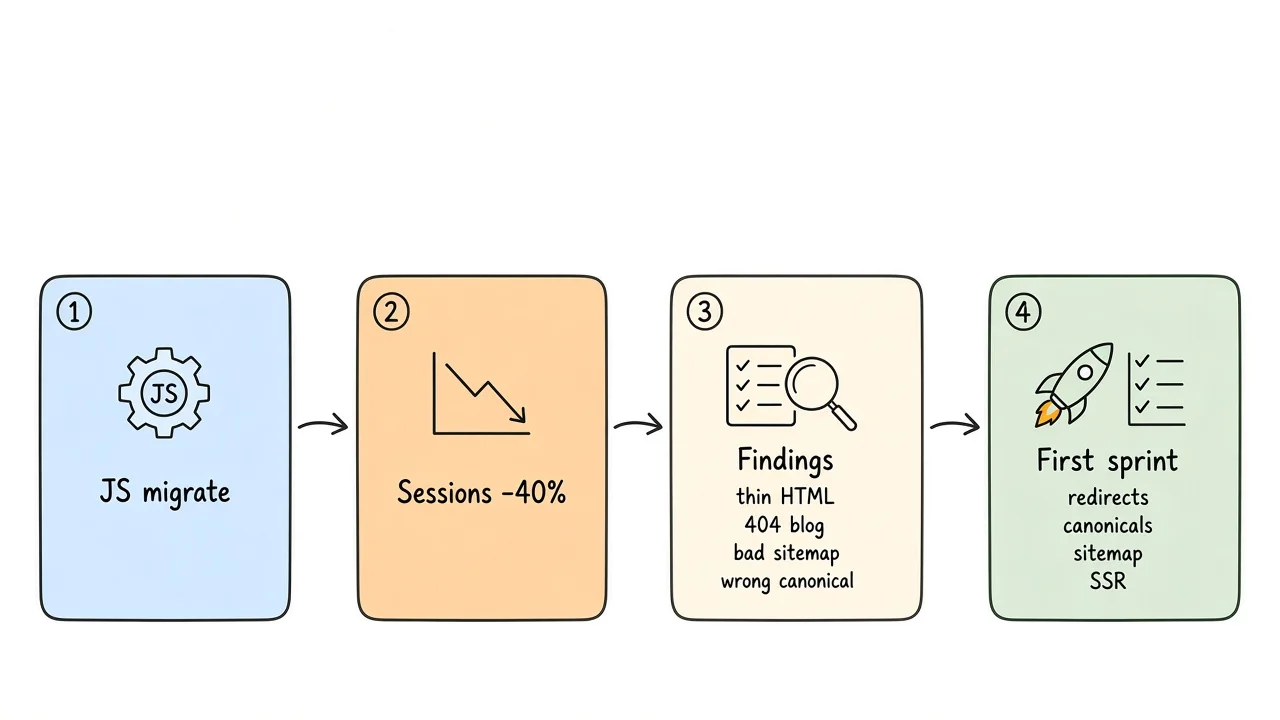
リダイレクト、カノニカル、サイトマップ、サーバーレンダードHTMLが、コンテンツとリンクより先に着地します。
よくある質問
テクニカルSEO監査にはどのくらい時間がかかりますか?
ほとんどの単一ドメイン監査は、アクセス準備後およそ1〜2週間で終わります。非常に大きなカタログは、テンプレートのスコープ付きサンプルと残りへの計画になります。
有用な監査にSearch Consoleは必要ですか?
大いに役立ちます。なくても、クロールと公開URLチェックで多くの問題は見つかりますが、カバレッジとCWVフィールドデータは薄くなります。
これはフルSEOパッケージと同じですか?
いいえ。このチェックリストはテクニカル診断と優先順位づけです。コンテンツ戦略、デジタルPR、継続的な最適化は、土台が明確になったあとの別作業です。
これらの項目を直せばランキングは保証されますか?
誠実な事業者なら約束すべきではありません。テクニカル修正はブロッカーを取り除き、コンテンツとリンクが働く余地を作ります。Googleは依然として競合と関連性に対して相対的にランクします。
AI Overviewや「GEO」については?
ページをクロール可能で明確で帰属可能に保つこと。AI引用を保証すると謳うスキームは避ける。実験的機能は、堅実なインデックスと有用なページの二次的なものとして扱う。
次にやること
クロールとSearch Consoleのチェックを順番に実行し、深刻度付きの短いバックログを書き、コンテンツ制作を広げる前に上位のブロッカーを出荷します。バックログや実装の第二の目が欲しければ、お問い合わせフォームから連絡してください。焦点を絞ったテクニカルSEO監査のスコープを決められます。